Magamról

Saját fotó
Főiskolai, majd egyetemi diplomamunkáimtól kezdve világ életemben, adatok, adatbázisok, adattárházak (leginkább Oracle) környékén mozogtam. Mostanság adattárházasként, adatbányászként élem napjaimat.

2013. november 21., csütörtök

Tableau: ETL-Monitoring GANTT-diagramon keresztül

.
Egy érdekes tárgybeli éles projekt DEMO-verziójának leírása következik alább, természetesen anonimizált adatokkal, de meghagyva az "éles kontextust".

FELADAT: 
Adva van egy ETL-eszköz (egyébként TALEND), ami mindenféle job-ok révén adatot tölt adatbázisokba.

LEÍRÁS, SCREENSHOT-okkal :
Miért érdekes a téma, hogy blogposztot szánok neki?
- Mert megmutatja (szvsz) a vizualizálás hihetetlen erejét: komplex Tableau-kalkulációk, dashboard, action filter, minden haladó üzleti intellgiencia hókusz-pókusz NÉLKÜL is.
- Mert ingyen (hiszen lehet-e létezni Tableau nélkül egy enterprise kategóriájú business-ben :), pár kattintással, sok embernek ad konszenzusos információt.

Adatokról:
- Vannak tehát JOBGROUP-ok
- Amik futásilag elindulnak (opcionálisan periodikusan)
- Kézzel vagy automatikusan
- Hétközben vagy hétvégén
- Tartanak valameddig
- Van nekik státuszuk
- Van nekik futási idejük
- Végül, de nem utolsó sorban vagy teljesítik az SLA-t (=Service Level Agreement), vagy nem.
- Futó JOBGROUP-ok esetén meg különböztetődnek az "in progress" meg "pending" job-ok. Az előbbi jó ("futhat"), az utóbbira lehet, hogy rá kell nézni. Minden JOB-nak van előélete (futott már korábban), ha vesszük a MAXIMÁLIS futásidőt, ezt szorozzuk egy konstanssal (pl.: 0.9-cel), akkor ez lehet egy küszöbérték, ami alatt "in progress", ami felett "pending"-nek vesszük az adott JOBGROUP-ot.

Mikor "jó" az ábránk, értve ezalatt, hogy a menedzser nyugodtan issza meg a kávéját, miután rátekintett.
- Minden automatikus JOBGROUP elindult
- Lefutott
- Sikeresen futott le minden
- Nem volt megelőzően sikertelen futás
- Belül van a futás vége az SLA-nak
- Futó JOBGROUP, ha van akkor "in progress"

Az igazi "real-life" projekt persze komplexebb volt:
- Voltak JOB-ok, JOBGROUP-okba szervezve (hierarchikusan)
- Voltak fontosabb és még fontosabb JOB-ok/JOBGROUP-ok
- Volt, hogy ebédtől(12:00) ebédig is kellett ábrázolni a napokat.
- Voltak effektív hibaüzenetek
- Voltak contextek
- A TALEND-logokat előemészteni, adatgazdagítani kellett
- stb.
Nem lehet célom a teljes projekt bemutatása egy ilyen blogposztban, még ez a maximálisan könnyített verzió sem lesz rövid.


1.
Ahogy megbeszéltük az elején, van egy kész "DEMO" adatforrásunk, a szükséges adatokkal (esetünkben 80.000+ rekorddal)
.


2.
Nézzünk bele az adatokba.
Rögtön az első oszlopnál (day_of_week), a WE(=WeekEnd) mutatja, hogy az adott nap hétvége-e.
A start_hours_minutes a 4:30-at 4.5-re konvertálja (60-as számrendszerről 10-esre áttérés)

.


3.
"Start Time" oszlopot konvertáljuk "CONTINUOS-ra"
.


4.
Ugyanígy az "End Time" oszlopot is konvertáljuk "CONTINUOS-ra"
.


5.
Válasszuki a "GANTT-diagrammot".
Az elképzelés az, hogy a vízszintes tengelyen lesznek a napok, függölegesen az órák [0-24]
Lesznek téglalapocskáink a  töltésekre (adott napon mettől meddig tartott egy töltés)
.


6.
Vonszoljuk fel drag and drop-pal a  "COLUMNS"-ba, a "DIMENSIONS"-ök közül a "DAY_OF_WEEK"-et. A színe automatiksuan kék lesz a "DIMENSIONS" miatt.
.


7.
Ugyamígy vonszoljuk fel a "ROWS"-ba a "MEASURES" -k közül a "START_HOURS_MINUTES"-t. A színe automatiksuan zöld lesz a "MEASURES" miatt.
.


8.
Mivel a "START_HOURS_MINUTES"-t measure-ként ismerte fel a Tableau (ennek aggregálási hátrányaival), konvertáljuk DIMENSION-né.
.


9.
Vonszoljuk a "MESSAGE_IMPORTANT_JOBGROUP"  dimenziót a "COLOR"-ra (ott balközép tájon).
A dimension-név mellett megjelent a jellegzetes, "COLOR"-specifikus ikon.
Nyilván szinesben szeretnénk látni, hogy sikeres-e vagy sem egy JOB-futás.
Kezd alakulni a vizualizációnk, megjelentek a várva-várt téglalapocskák, ráadásul színesen :)
.


10.
A Tableau default-ban "ZÖLD"-re rakta a "sikeres"-ket (ami jó), de a "sikerteleneket" "KÉK"-be. Ezért az utóbbi módosítsuk "PIROS"-ra
.


11.
Ki kell jelölni a "FAILURE"-t, majd lehet a "PIROS" négyzetre klikkelni.

.


12.
Rögtön jobban elüt a sikeres töltés a sikertelentől :)
.


13.
Vonszoljuk fel a "DURATION_IN_HOUR" measure-t a "SIZE"-ba.
Nyilván egy téglalap annál hosszabb. minél tovább tartott a futás idő.
A measure-név mellett megjelent a jellegzetes "SIZE"-specifikus ikon.
.


14.
Formázzuk meg a függőleges tengelyt.
.
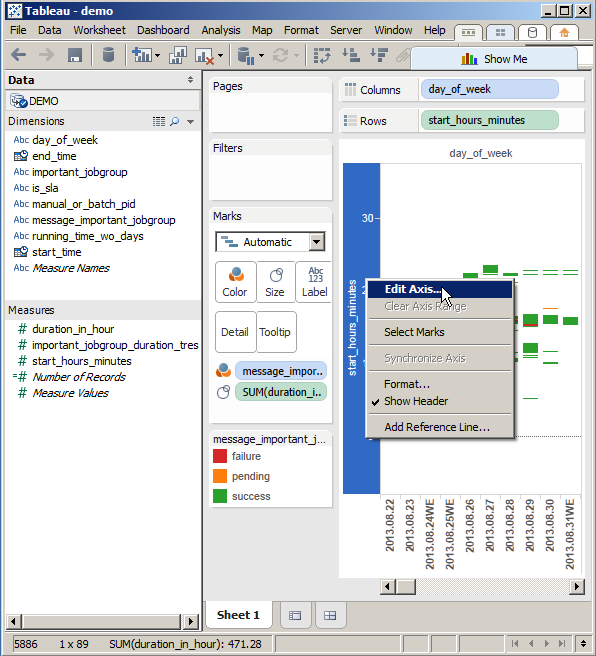

15.
Ne automatikus legyen, nem szimpatikus értékekkel
.


16.
Hanem "FIXED", elvégre egy napban mindig konstansan 24 óra van. :)
.


17.
A skálázás se default automatikus legyen
.


18.
Hanem félórás léptékű.
Ez még nem túl sok, de már elég finom felbontás
.


19.
Gyönyörködhetünk a frissen elkészült függöleges tengelyben.
.


20.
Jöhet a vízszintes tengely
Én elfordítottam "ROTATE"-tel 90%-kal a napokat (default beállítással szemben), hogy több napot lehessen egybe látni.
Mivel a napok végén van a "WE", ha hétvégére esik, így azonnal szembeszökik, hogy melyik nap hétvége.
Nyilván kérdés, hogy a WE hol mutat jobban, a dátum elején (szintbehozva a dátumokat) avagy a végén. Ez ízlés kérdése, nekem így tetszett jobban :)
Nyilván szebb lenne, ha a tengelyen szinezni lehetne a napokat, de ez kulturáltan nem kivitelezhető a Tableau jelenlegi 8.0-s verziójában. Valami ígéret van, hogy 8.1-ben lesz előrelépés ez ügyben is.
.


21.
Most már jöhet a diagram formázása.
.


22.
Nyilván szeretnénk valamiféle GRID-et, hogy jobban vezetődjék a szemünk.
A gridnek van vonaltípusa, vonalvastagsága, vonalszíne.
Külön felhívnám a figyelmet, hogy ezt a várakozásokkal ellentétben, nem a "GRID"-ikonra kattintva lehet beállítani, hanem a "LINES"-nál ;)
.


23.
Egyre inkább alakul :)

.


24.
Természetesen (quick)filterek nélkül nem élet az élet.
Vonszoljuk fel az "IMPORTANT JOBGROUP"-ot a filterek közé
Válasszuk ki a "USE ALL"-t (hogy mindenből lehessen választani)
.


25.
Majd pipáljuk be a "SHOW QUICK FILTER-t"
.


26.
Lám jobb oldalon megjelent a kívánt quick filter. :)
.


27.
Helykímélésből nem ismétlem meg a screenshot-okat
A további mezők quick fitleresítése ugyanígy megy.
- MANUAL_OR_BATCH_PID
- MESSAGE_IMPORTANT_JOBGROUP
- IS_SLA
stb. (igény szerint)
.


28.
Quick filtereknél  lehet állítani, hogy "ONLY RELEVANT VALUES".
Ennek az az értelme, hogy mivel minden mindennel összefügg, lehet, hogy egy kattintás nyomán nem lesz az ábrán minden lehetséges érték - például csak sikeres futások találhatók adott kontextusban. :)
.
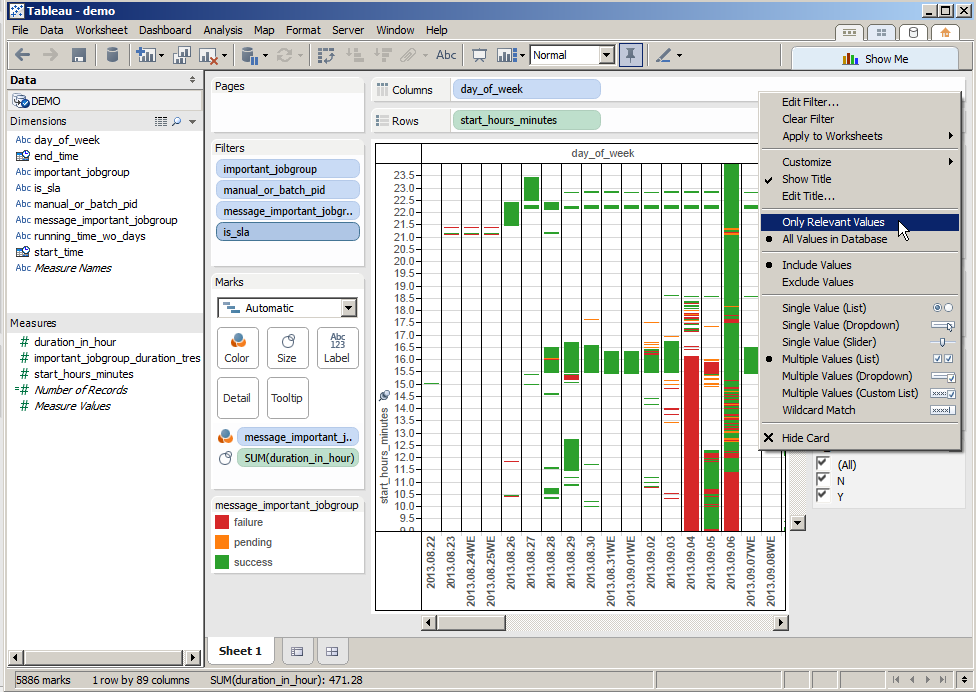

29.
Hátravan a téglalapocskák  "TOOLTIP"-ezése
Ehhez elsőként a megjelenítendő adatokat vonszoljuk a "DETAIL"-be.
Elsőként az IMPORTANT_JOBGROUP-ot
.


30.
Majd:
RUNNING_TIME_WO_DAYS (00:00:00 formában mutatja a futási időt)
START_TIME-ot
.


31.
YEAR(START_TIME) defaultot , állítsuk "EXACT DATE"-re.
.


32.
Ugyanígy az END_TIME-nál is, ismételjük meg ezt.
.


33.
A TOOLTIP-re kettőt kattinva, notepad-szerűen szerkeszthetjük a TOOLTIP-et
.


34.
Sőt meg is nézhetjük "PREVIEW" -val mit alkottunk.
.


35.
Így néz ki a TOOLTIP élesben
.


36.
Mivel előbb-utóbb több napnyi adat lesz, mint ami egy képernyőre kifér, célszerű állítani, hogy csak az utolsó X nap látszódjék
.


37.
Ezt kell állítani hozzá
.


38.
És készen vagyunk.

Nyilván egyéni ízlés szerint lehet finomhangolni vizuális elemeket, egyebeket.
Az én főnököm például jobban szereti a rádiógombokat, míg én meg a checkbox-okat szeretem jobban, stb. :)
Vagy lehetne vízszintes referenciavonalat húzni az SLA-hoz, például reggel 8:00-hoz
A lényegen ez már nem változtat. ;)

Mit látunk?
Bár korábban volt rendesen sok piros, mostanra normalizálódott a helyzet, egyre több a zöld, egyre kevesebb a piros téglalap. Ráadásul mindegyik ugyanakkor indul automatikusan, nem kézzel kell hackelni, hibalehetőségekkel. Sőt a még a futási idők is hasonlítanak egymásra.

Mire nem jó egy vizualizáció ugye :)

.


Eddigi TABLEAU-blogposztjaim:
2013.06.17 - Data Science: Tableau-feladatok
2013.06.22 - Tableau: Egy vizualizációs stratégia lehetséges szubjektív sarokpontjai
2013-07-05 - Tableau: Mindennapi örömök
2013.07.09 - Tableau: Eset a NEM-létező egzotikus nagygépes adatpiaccal
2013.11.16 - Tableau: Aktuális Pros/Cons egyenleg
2013.11.17 - Tableau: Text Table  

Ha valakinek még nincs meg a Tableau-szoftver, miközben szeretne engedni a birtoklási csábításnak, az alábbi mail-címen egy kedves, fiatal, aranyos kolléganő igyekszik hatékony és konkrét eszközök segítségével ápolni minden Tableau-vonzatú kapcsolatot. Illetve biztos segít optimális árat találni a termékhez vezető rögös úton. :)
hello@tableausoftware.hu

2013. november 17., vasárnap

MP3 zenei hangfile-ok műfaji besorolása adatbányászattal

.
Jelent meg egy friss könyv Coelho billentyűzetéből. De ez egy másik Coelho. ;)

Willi Richert, Luis Pedro Coelho - Building Machine Learning Systems with Python

Ez a könyv már a 4.fejezetében elkezd "durvulni", LDA(="Latent Dirichlet Allocation")-s topik-modellezéssel.

Nade, ami a 9.fejezetben érkezik, attól kivirul az adatbányász szíve ;)

Music Genre Classification=Zenék műfaji osztályozása gépi algoritmussal, pár soros Python-kódolással.

Itt van a felhasznált 1.1 GB-nyi dataset különféle zenék MP3-jaival. 10 műfaj (klasszikustól a rockig), minden műfajban 100-100 zenével, úgy hogy az számok első 30 sec-je van az MP3-ban.
http://opihi.cs.uvic.ca/sound/genres.tar.gz

WAV-vá alakítás után döbbenetes, hogy egy szimpla FFT (="Fast Fourier Transformation") milyen erős/hatékony tud lenni). Úgy csökkent dimenziót, hogy bombaerős feature-öket generál.

Az ugye mindenkinek megvan, hogy miért kellett WAV-ba konvertálni? Merthogy a WAV tömörítetlen formájában egy kvázi adatbázis, hangfizikai jellemzőkkel (csatorna, mintavételezés, bitmélység, stb)

Itt alább látható a gépi osztályozás minőségéről egy kép. A klasszikus és metál a legjobban elkülöníthető és a jazz a legkevésbé :
Megjegyzés: számomra a 0.99 AUC túlságosan szépnek tűnik, hogy igaz legyen, de nem kizárt.

Tableau: Text Table

.
Végre volt egy kis időm, hogy a tárgybeli cucc "algoritmusát" megírjam - ami "algoritmus" az én ízlésemnek kicsit komplikált, egy "funny" felhasználóbartá szoftver esetében. Pláne, hogy irányomba történt személyes megkeresés is volt az ügyben.

FELADAT: A "view data"-hoz hasonló kétdimenziós táblát szeretnénk a "nagy" Tableau-ban is, natúr, nyers adatok formájában - mindenféle pivotálás meg üzleti intelligencia okosság nélkül megjeleníteni.

MEGOLDÁS:

1.
A Tableau megnyitása, vegyük a Tableau-hozdemóként kapott SuperStore Excel-t.


2.
Az adatforráson jobb egérklikk után nézzünk bele az adatokba, hogy mit is szeretnénk látni.


3.
Az adatok mellett (amit majd látni szeretnénk), látjuk, hogy 9.426 rekordunk van az Excel-ben.


4.
Baloldalon a "Measures"-nél, az üres fehér részen jobb egérklikk után "Create Calculated Field"-er válasszunk.


5.
A megnyíló ablakban hívjuk az ujonnan kalkulált mezőnket ROWNUM-nak, a számítási képlete meg legyen INDEX(). A dolog vélja, hogy be tudjuk sorszámozni a rekordjainkat (mesterséges integer ID)


6.
Az OK-ra való enter után megjelenik szépen a ROWNUM.  


7
Vonszoljunk fel "drag and drop"-pal ezt a ROWNUM-ot a "Rows"-hoz


8.
Ott fenn, jobb egérklikk után "Compute using" és "Table (Across)"-t válasszuk ki.


9.
Majd ismét jobb egérklikk és következzék a "Discrete"


10.
Zöldből kékbe váltott a ROWNUM ennek nyomán.


11.
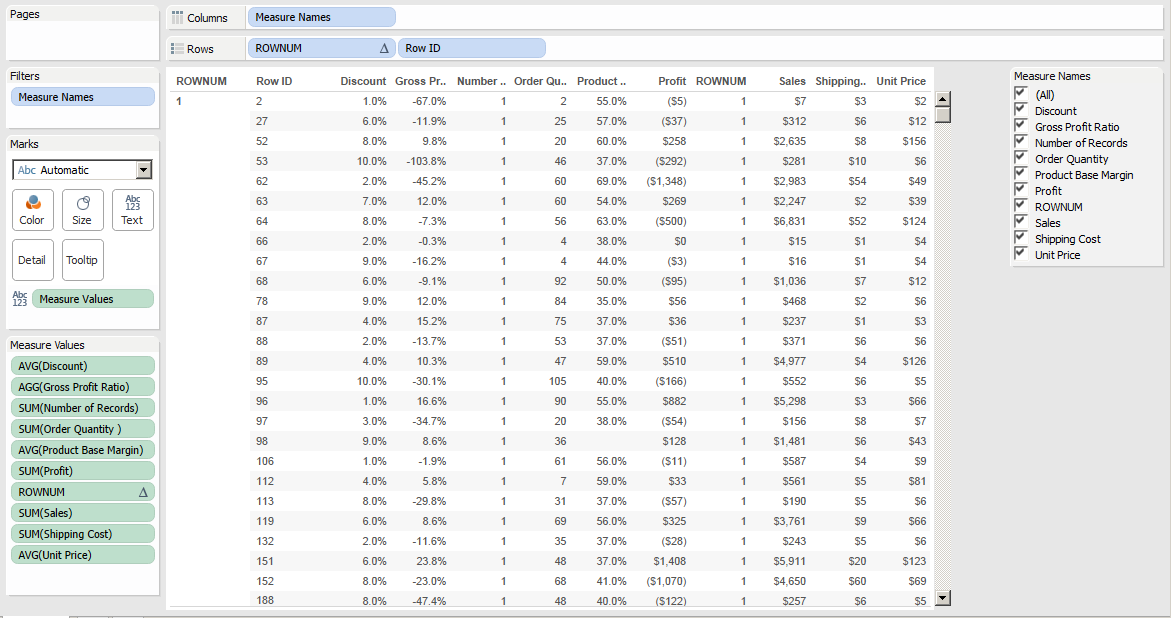
A "Dimensions"-ből a predefinit "Measure Names-t" vonszoljuk a a "Columns"-ba


12.
A "Measure Names"-n jobb egérklikk, és pipáljuk be a a "Show Quick Filter"-t. Ezzel tudjuk majd ki be kapcsolgatni, hogy mely mezők jelenjenek meg.


13.
A "Filters"-ek között is megjelenik ezáltal a "Measure Names"


14.
Vonszoljuk a "Measures"-ből a szintén predefinit "Measure Values"-t az "ABC-Text"-be (ott engedjük el).
Ezzel megjelennek a measure-jeink, az első rekordra.


15.
A "Dimensions"-ből vonszoljuk például a "RowID"-t a "ROWNUM" mellé.
Egyelőre azt látjuk, hogy a "ROWNUM"=1 minden rekordra.


16.
A "ROWNUM"-on jobb egérklikk, és ismét állítsuk be, hogy Table (Down)


17.
Ezennel szépen egyesével fognak növekedni a ROWNUM-ok, amit akartunk.


18.
És most jön az egész mókolás után az orgazmusos rész: vonszoljuk a Dimensions-ből "Ship Mode"-t a "RowID" mellé. Nem kellett "Measure"-ré alakítani egy dimenziót, mégsincs pivotálás, hanem rekordonként szépen megjelenik a dimenzio értéke, amit el akartunk érni.


Eddigi TABLEAU-blogposztjaim:
2013.06.17 - Data Science: Tableau-feladatok
2013.06.22 - Tableau: Egy vizualizációs stratégia lehetséges szubjektív sarokpontjai
2013-07-05 - Tableau: Mindennapi örömök
2013.07.09 - Tableau: Eset a NEM-létező egzotikus nagygépes adatpiaccal
2013.11.16 - Tableau: Aktuális Pros/Cons egyenleg
2013.11.17 - Tableau: Text Table

Ha valakinek még nincs meg a Tableau-szoftver, miközben szeretne engedni a birtoklási csábításnak, az alábbi mail-címen egy kedves, fiatal, aranyos kolléganő igyekszik hatékony és konkrét eszközök segítségével ápolni minden Tableau-vonzatú kapcsolatot. Illetve biztos segít optimális árat találni a termékhez vezető rögös úton. :)
hello@tableausoftware.hu

2013. november 16., szombat

Tableau: Aktuális Pros/Cons egyenleg

.
Megpróbálom lajstromolni tárgyilagos, független szemmel a Tableau előnyeit-hátrányait prioritásilag csökkenő sorrendekben, később meg karbantartani.

Előre szólok, nagyon nagy az anyag....


ELŐNYÖK:


* Nagyon gyors, mind adatkezelésében, mind vizualizáció megjelenítésben. Annyira gyors, hogy még cachelés sincs benne. ;), köszönhetően, hogy natív C-ben íródott.

* Gyönyörű, szintén köszönhetően, hogy natív C-ben íródott. Az én felfogásomban, minden Java-s cuccot megelőz ebben a két első szempontban.

* "Big Data kompatibilis". Lásd Földi Tamás (Starschema fejlesztési vezető) legutóbbi Budapest BI fórumos prezentációját: "300 millió rekord adatok fénysebességgel, virginai Vectorwise-szerverről, interneten keresztül, 1 másodperces lekérdezésekkel"

* Reális árú.
Idetartozik, hogy használható még a a free-verzió is (nem átvágás).
Míg a nagy tudású  desktop-verziót Magyarországon van, aki 1.600 USD-ért is meg tudta venni. Azaz durván nettó 320.000 forint. Verhetetlen technológia, megfizethető árral.
Az enterprise árszabás már nem tartozik ide, de az külön történet.

* "Funny" használni. Ennek van árnyoldala is: addiktív eszköz, bele lehet feledkezni, a világ minden ideje is kevés lehet hozzá.

* Közel 40 adatforráshoz kapcsolódás lehetősége.
Plusz ODBC (alig van már olyan, hogy valaminek nincs ODBC-je, még HIVE és CASSANDRA is elérhető vele).
De ha nincs ODBC, akkor ODBC-JDBC gateway-jel JDBC-s adatforráshoz is lehet kapcsolódni.
Olyanról meg aztán végképpen nem hallottam, hogy valamihez se ODBC, se JDBC ne legyen, sőt Tableau-ból se legyen elérhető.

* Adatpiacépítéssel nagyon szépen bővíthető a Tableau saját ökoszisztémája. Azt gondolom, hogy adat szinten kvázi nincs olyan feladat, amit ne lehetne Tableau alá pakolni. Ami korlát van, az mind magában a Tableau vizualizálási folyamatban van.

* Közvetlen SQL-ezés remek lehetősége, még egy szimpla Excel állománynál is.
Nem mondom, hogy teljes kiszerelésű, de használható annyira, hogy a hátrányok között ne említsem a fapadosságot.

* SQL-be átvehetők Tableau-s paraméterek.

* RAWSQL, csak szerveroldalon létező SQL-funkcionalitás hívásának lehetősége. De megemlíthető az is, hogy gazdag a kalkulációs választék. Nem nagyon van olyan, hogy ami megy Excelben, az nem megy Tableau-ban, a fordítottja sokkal inkább életszerű :)
Igaz az Excel-ben lehet VBA-zni, amit a Tableau-ban nem. :(

* Data Blending lehetősége. Közvetlen use case, hogy vállalati adattárház nem feltétlen tartalmazza a legfrissebb adatokat, legfrissebb piackutatásokat. Így egy heterogén adatforrásból rágörgetve a plusz adatokat egységesen kezelhető az egész cucc a Tableau vizualizálási folyamatban. Én érzem a technológia túlragozásának veszélyeit, de nem akarok ünneprontó lenni evvel most.

* Hatalmas piros pont a saját fileformátum okos tervezéséért.

- TWBX=Packaged Tableau Workbook (amiből eXtractolni lehet infókat)
Ez egy síma zip, ami tartalmazhatja többek közt a
(1) TDE-formátumú adatforrásokat(2) XML-formátumú "vezérlést", valamint opcionálisan
(3) Segédállományokat, például képeket.

- TDE=Tableau Data Extract. Ez egy  proprietary bináris fileformátum, ami a legtömörebben tárol (COLUMN-STORE DATABASE koncepciónak köszönhetően), hiszen manapság háttértárról olvasni a legköltségesebb művelet (netes fel-letöltögetésekről már nem is beszélve), szemben a processzor és memóriaműveletekkel (lásd RDBMS-ekben is a tömörített táblatereket vagy egyenesen a columnar-oriented DBMS-eket). A nevezetes Bird Strikes Access-ben 105 MB, CSV-ben 71 MB, Excel-ben 56 MB, TDE-ben 20 MB. Azért érezzük át egy pillanatra ennek kiemelt piros pontos jelentőségét.

* Van a TDE-hez hozzá kultúrált programozói API is. Mivel proprietary bináris a fileformátum, így a lényegi funkcionalitást DLL-ekben kapjuk. Sajnos csak befele irányban, kifele nem. Ez utóbbi nagyon durva hátránya egyébként.

* Megjelent a Tableau az akadémiai/egyetemi szférában.
Csak amiről én tudok: Prekopcsák Zoltán

* Elég jól és olvashatóan dokumentált, az egész ökoszisztéma átlátható: van egy 1000 oldalas publikusan letölthető PDF Manual, ~70 db Advanced Techniques Guide, ~50 db Webinar, fórum, community.

* A Free Tableau-használat, 1GB adatig szabad vizualizálás

* Fejlődő funkcionalitású "enterprise sclability"

* Működő progressbar. Ne becsüljük le a jelentőségét. Nem triviális implementálni, ezért szeretnek róla elfeledkezni, hanyag módon megcsinálni.

* Nagyon gyors, ergonomikus install-folyamat

* Felhőben, oktatási folyamat részeként jól használható (saját tapasztalat, Coursera Data Science kurzus)

* Külön is kiemelve, hogy natív C-ben íródott, azon céllal, hogy tudjak vastagítani. :)

* Mobilplatform aspektusokat nem vagyok hajlandó tárgyalni, annyira távoláll tőlem világnézetileg, annyival izgalmasabb topikok vannak. ;) Számomra ez egy tipikus pótcselekvés és bullshit melegágy, ami elodázza csomó lényeges kérdés megválaszolását.


HÁTRÁNYOK:


* Nálam a legeslegnagyobb fekete pont, hogy TDE-re  nincs ODBC, sőt nincs semmilyen API az adatok (pl.: kalkulációk) kinyerésére. Az adatok demokratizálásának, meg self-service égiszei alatt nehéz túlbecsülni ennek jelentőségét.

* Ráadásul, tudván-tudom, hogy ha nehézkesen is, de elérhető a TDE-adatok kívülről is, viszont keresztbefekszik ennek publikálásának a Tableau cég, mondván, hogy a licence feltételek reverse-engine korlátozásába nem fér bele. Ritka barátságtalan gesztus a cégtől. Adatok demokratizálásának kerékkötése ez.

* "Natív" text tábla megjelenítésének baromi nehézkessége. Volt olyan megkeresés - nálam személy szerint -, hogy ultra-brutál jó a Tableau, meg minden, de egy táblát hogy mutatok meg szimplán. Az a mondás, hogy a Tableau nem erre van. De érezzük át, hogy ez nem egy szimpatikus mondás!
A data view-gridben sem select-oszlop sorrendben jelennek meg az adatok
A munka-régióban sem lehet akárhány oszlopot felsorolni.

* "Oracle APEX analógia", az első lépések nagyon egyszerűek, gyorsak, látványosak, beetetősek. A profi (érdemi) munkához viszont már "exponenciálisan" göröngyös az út. Nagyon nehéz minden "bitet" uralni/kontrollálni benne.
Több éles Tableau-projekt után ki merem jelenteni, hogy a tanulási görbéje kihívásokkal küzd. ;)

* Nagyon nehéz rendesen megtanulni a Tableau-t, egyáltalán kérdezni Google-ban bárhol (megfogalmazás szinten). Nincs olyan mint a programozóknál, hogy "reference guide" vagy "kulcsszavas keresés".
Egyáltalán belőni, hogy mit lehet és mit nem a Tableau-ban.
Lehet, hogy egy egész élet is kevés hozzá? ;)
Amúgy meg eszi az ember idejét rendesen a Tableau-val való foglalkozás. ;)

* A Manual lehetne sokkal jobban szervezett, bővebb illetve kevesebb redundanciát tartalmazó, ha már 1000 oldalas.

* A dashboardok, sheetek lehetnének jobban szervezettek. Egy lehetséges eljárás, hogy két sorban jelennének meg (nem keveredve), vagy valamiféle hierarchiába zárva

* Biztos van akinek fáj, a Linux-támogatás hiánya, de, hogy 64-bites Windows sincs natívan támogatva, az nekem kicsit durva (v8.0-ban csak 64-bites TDE-engine van, illetve a programozói API is ennek megfelelően lehet 32- és 64-bites).
Mondjuk ez a "részelegesség" v8.1-re változni látszik, a béta program alapján, azaz készül a teljesen 64-bites Tableau Desktop is. :)

* Self-service BI centrikusság, meg "adatok demokratizálása" irányába elviszi a gondolkodást, például a collaboration - gondolkodás - szerintem - helyes irányának kárára. Nagyon nehéz párhuzamosan dolgozni egyetlen vizualizáción.

* Nekem nagyon fáj, hogy nincs programozási lehetőség (kvázi makró rögzítés, és olvasható Visual Basic szerű kód, settingekre, klikkelés-sorozatra, stb). Borzasztó nehéz reverse engine-lni egy vizualizációt, reprodukálási céllal. Ami azért is nagyon gáz, mert vizualizáció alatti adatforrás bővítés/csere távolról sem triviális mutatvány.

* Nincs meg a lehetősége teljes vizualizálási kontrollnak, nem uralhatók a bitek. Nem tud mindent a Tableau. Ha van egy dátum tengelyem, szeretném beszínezni a dátumokat aszerint, hogy hétvége-e vagy munkanap, nem tehető meg kulturáltan, csak hackeléssel és nem szépen. Workaround van persze, de könyörgöm szép vizualizálásról beszélgetünk a Tableau kapcsán. ;)

* Caching hiánya. ami elvezet a felhasználók felfelé skálázásának problémájához is, internetes környezetben. Egy Microstrategy előrébb tart a témában.

* TDE-knél a 2GB limitet nagyon, de tényleg nagyon nehéz kinőni, de akkor is hátrány, hogy ilyen alacsonyan van, indokolatlanul.

* Visual Data Mining inkább csak adatfeltárás szintjén mozog, az is max 7-8 változó egyidejű kezeléséig (mert ab ovo nehéz a vizualizálásuk), ráadásul jelentős manualitás igénnyel. Pedig feature-selection-t, klaszterizálást, döntési fákat, logisztikus regressziót, ajánlórendszeres aspektusokat, szívesen vizualizálna az ember, interaktívan. Ezekből egy Datameer, már ma is nemkeveset támogat.

* Az enterprise árszabás már közel sem olyan barátságos, mint a személyes használat. Ezt tekintve lehetnek jobb választási alternativák: Datameer, Karmasphere, Platfora, horribile dictu D3.js

* Az  enterprise scalability bőven tudna még nagyon hová fejlődni. Nincs verziókövetés, érdemi collaboration-támogatás, account+password felhasználó oprendszerre hárítódik teljes egészében. Nincs ugye caching, stb.

* A tól-ig dátum slider-ből nem vehető át paraméter SQL-be. Nem igazán értem miért.

* Adatfrissítés szimpla refresh-sel nem mindig kivitelezhető, van amikor drasztikusabb "szálljunk ki szálljunk vissza" módi kell.

* Group by-os dolgok kezelése eléggé korlátosak. Nem túl jelentős dolog, mert adatpiacépítés szintjén támogatható a funkcionalitás, ezért is hagytam a legvégére.


UPDATE v8,1ß (2013-11-16):


* A fenti hátrányokból egy-kettő megszünni látszik, remélhetőleg a közeljövőben :)

- 64-bit Windows teljes natív támogatása, ugye.

- R-integráció. Ez egyre inkább elvárt és kötelező mutatvány. Szerencsére. :) Ezzel javulhatnak a faltól-falig Visual Data Mining esélyei. :)

- "Start of week support". Lehet, hogy mégis fog menni a dátumos tengelyen a hétvége/munkanap kulturált megkülönböztetése

* SAP-BW táblák TDE-be olvasása.


Zárszóként elmondanám, hogy nálam pozitív az egyenleg (súlyozott összegzés után), illetve a hátrányok bőven leküzdhetők, fejlesztői jóindulat esetén.

Illetve nagyon szerettem volna a Tableau VizQL-jének erősségét valamiképpen minősíteni, de ehhez egyelőre még kevésnek érzem magamat.


Eddigi TABLEAU-blogposztjaim:
2013.06.17 - Data Science: Tableau-feladatok
2013.06.22 - Tableau: Egy vizualizációs stratégia lehetséges szubjektív sarokpontjai
2013-07-05 - Tableau: Mindennapi örömök
2013.07.09 - Tableau: Eset a NEM-létező egzotikus nagygépes adatpiaccal
2013.11.16 - Tableau: Aktuális Pros/Cons egyenleg
2013.11.17 - Tableau: Text Table

Ha valakinek még nincs meg a Tableau-szoftver, miközben szeretne engedni a birtoklási csábításnak, az alábbi mail-címen egy kedves, fiatal, aranyos kolléganő igyekszik hatékony és konkrét eszközök segítségével ápolni minden Tableau-vonzatú kapcsolatot. Illetve biztos segít optimális árat találni a termékhez vezető rögös úton. :)
hello@tableausoftware.hu

2013. november 14., csütörtök

Kép egy friss szövegbányászati monográfiából.

.
Practical Text Mining and Statistical Analysis for Non-structured Text Data Applications

A fenti 1000+ oldalas hatalmas, fajsúlyos, 2012-es megjelenésű szakkönyv érdekes struktúrában tárgyalja a szövegbányászatot.
I: Szövegbnyászati alapok és elvek
II: Tutorialok (közel 30 db), ez a könyv legnagyobb része (kb.: kétharmada)
III. Haladó témák.

A három nagy kereskedelmi szövegbányászós szoftvert veszi alapul (sorrendben: IBM SPSS Modeler Premium, SAS Text Miner, Statistica Text Miner). Ez is közrejátszhatott abban, hogy relatíve olcsó a könyv ;) Mondjuk a Rapidminer és Knime vonatkozó moduljainak említése meg fájdalmasan hiányzik.

Van a könyv első lapjain egy remek ábra. Amikor ennyi információ van belesűrítve egy vizuálisan ütős ábrába, akkor meg tud lágyulni a legszőrős szívűbb olvasó is :)

Az ábra a szövegbányászat  fontos területeit hivatott összefoglalóan mutatni. Mondjuk a felső nyil értelmét nem tudtam így korán reggel azonosítani.


2013. november 10., vasárnap

Julia

.
John Myles White: Julia, I Love You (2012.03.31)

"We want a language that’s open source, with a liberal license. We want the speed of C with the dynamism of Ruby. We want a language that’s homoiconic, with true macros like Lisp, but with obvious, familiar mathematical notation like Matlab. We want something as usable for general programming as Python, as easy for statistics as R, as natural for string processing as Perl, as powerful for linear algebra as Matlab, as good at gluing programs together as the shell. Something that is dirt simple to learn, yet keeps the most serious hackers happy. We want it interactive and we want it compiled. (Did we mention it should be as fast as C?)"

Why Julia?


Links:
Julia Language
Julia External Packages
Julia Standard Library
Julia Documentation
Julia Studio-An integrated development environment for the Julia language.

Does Julia have any hope of sticking in the statistical community?

2013. november 8., péntek

(Programozási) nyelvek/eszközök adatbányászathoz

.
A KDnugets idei és eddigi legfrissebb (augusztusi) felmérésének össezsítése:

What programming/statistics languages you used for an analytics / data mining / data science work in 2013? [713 votes total]
"Languages for analytics / data mining / data science"


 És akkor a közvetlen reakciós kommentjeim. ;)

* Az R megkérdőjelezhetetlenül első ma még mindig, de azért csökken az aránya. :)
- Az R úgy régóta kiforrott, magasszintű, gyors illetve támogatott csomagokkal, hogy nagy hátránya nincs, így a kiemelt szerepe magyarázható. Két ellenérvet tudok mindössze felhozni, de azok is eröltetettek:
- Speciális célú nyelv
- Az R annyira és akkora referencia, mint a Weka. Igazodási pont, mindenki akarja közvetlenül támogatni: olyan gigászoktól elkezdve,mint az Oracle. De pont ez a hátránya is, hiszen halványítólag hathat rá, ha a támogatók komoly hozzáadott értéket tudnak mellé tenni, "konkurensként".

* A Python - azt gondolom szerencsére - egyre inkább előretör.
- Az én vesszőparipás kérdésem régóta:  mi az amit a Python nem tud ugyanolyan jól vagy egyenesen még jobban, mint akár egy R vagy Octave? Milyen hátránya van?
- A lambda-kalkulussal még a funkcionális nyelvek felé is nyitott (bár ezt Java alapokon nyilván triviálisabb szemlélni)
- Általános célú nyelv.
- Rapid módon növekvő csomagok, könyvtárak, és egyre inkább minden lényeges pontot lefedően.

* SQL a harmadik helyen. Yessssssssssssssssssssssssssss! ;)
- Aki ismer, az még keveselheti is az "s"-ek számát a fenti "yes"-ben :)
- Nálam übereli a visual-streamek fontosságát is.
- Az SQL roppant kifejező nyelv
- Data Mining felé is nyitott, lásd Oracle (9i-től).
- Azon szűk halmazába tartozom a világ népességének, aki szerint, az a feladat, amit SQL-ben nem lehet megcsinálni, az nem létezik :)
- Egyetlen csúnya vonása a nyelvjárások sokasága.

* SAS negyedik helye viszont nagyon fáj gyarló személyemnek. :(( /legnagyobb ellendrukkerük vagyok/
- A SAS semmi úttörő jelentőségű hozzáadott értéket nem adott a szakmában (visual stream az angol Integral Solution Ltd (ISL) találmánya volt, akiktől megvette a terméket az SPSS 1999-ben)
- Végtelen - profitmaximalizálásnak hívott - kapzsiságával tán legkomolyabb kerékkötője volt a data mining nagyobb terjedésének.
- Szegényes node-készlet, korlátos funkcionális tudás jellemzi (más termékekhez viszonyítva)
- Per a mai napig minden határon túl eszement drága: nem is érti az ember, hogy hogyan élnek meg.
- Azt viszont el kell ismerni, hogy valamit tudtak/tudnak, ha 2013-ban ilyen erősek a pozicióik.

* Java korrekt pozicióban van és örömteli alternatíva volt eddig is, meg lesz ezután is remélhetőleg.Ha egy Apache Mahout-ra gondolunk, az innováció itt sem áll meg.

* Sajnálom, hogy a Matlab ennyire megelőzi az Octave-ot
- Nem vitatom jó eszköz a Matlab, jó dolgozni vele, nemvéletlenül szeretik az egyetemek.
- Az ecoysysteme meggyőzően kiterjedt.
- Az ára viszont nagyon túlzás
- Pláne úgy, hogy matlab programokat mások tudnak gyorsabb végrehajtásúra fordítani.
- Az Octave-ról mindent elmond, hogy a Coursera-s kurzusok rajta keresztül igyekeznek tanítani a Machine Learning jellegű tárgyakat. :)

 * High-level Data Mining Suite. Azt kell mondjam jogos az előkelő helyezése. Teljesen jó és támogatandó alternatíva. Nem is érdemes, nem is szabad ellene küzdeni.

* Awk/Sed/Perl....
- Iziben dobtam egy hátast, ezekre az atavisztikus csökevényekre. ;)
- Én elhiszem, hogy beléjük lehet szeretni, de annyira, hogy minden mást ignorjon valaki előre és látatlanba.
- Meg ad absurdum, az assembly, akkor miért nincs a listában? Az is van olyan nehezen olvasható és módosíthatatlan, mint a fentiek.
- Azért attól remélem messze vagyunk, hogy egy növekvő részhalmaz lenne. ;)

* Pig és Hive még messze van az SQL-től.Sokat kell még fejlődniük, többet mint az ábra tükröz. ;)

* Funkcionális nyelvek mindenütt.
Ismét csak megállapíthatóan
És végül is meg is érthető, sőt egyre inkább megérthető a dolog,

* Ezt a Juliát egyre többet látom, most már lassan rá fogok keresni, mi fán terem :)